robots.txtとは?SEO効果や設定方法、注意点など解説
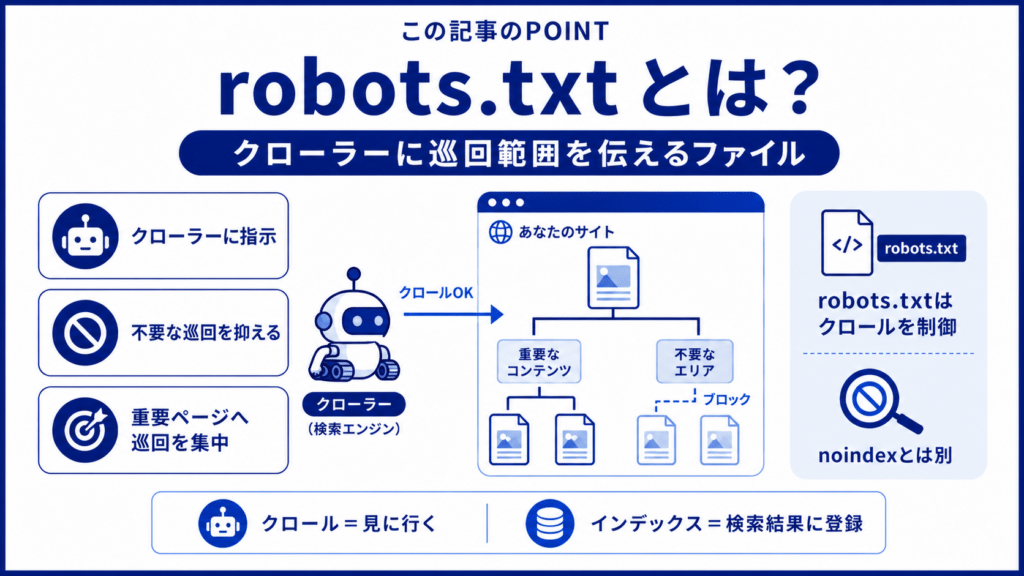
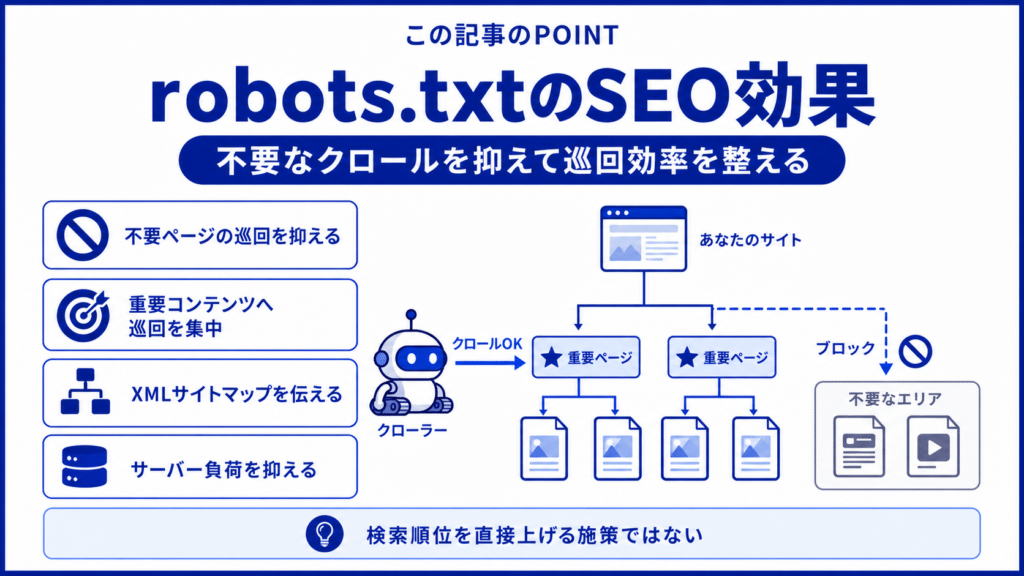
robots.txtは、検索エンジンのクローラーによるWEBサイトの巡回を制御するためのファイルです。適切に設定することで、不要なページへのクロールを抑制し、重要なページを効率よく巡回してもらうことにつながります。
一方、設定を誤ると、検索エンジンが重要なコンテンツを読み取れなくなり、SEOに悪影響を及ぼす可能性もあります。そこで、robots.txtの基本的な仕組みやSEO効果、具体的な設定方法、注意点などについて分かりやすく解説します。
■この記事で分かること
- robots.txtの基本的な役割と仕組み
- robots.txtを設定することで期待できるSEO上の効果
- クロールを許可・拒否する基本的な設定方法
- robots.txtで拒否しない方がよいページの考え方
- 設定時に注意したいポイントと確認方法


記事が参考になりましたら、Google検索やAI検索で東京SEOメーカーを見つけやすくなる「優先ソースへの追加」をお願いします。
robots.txtとは
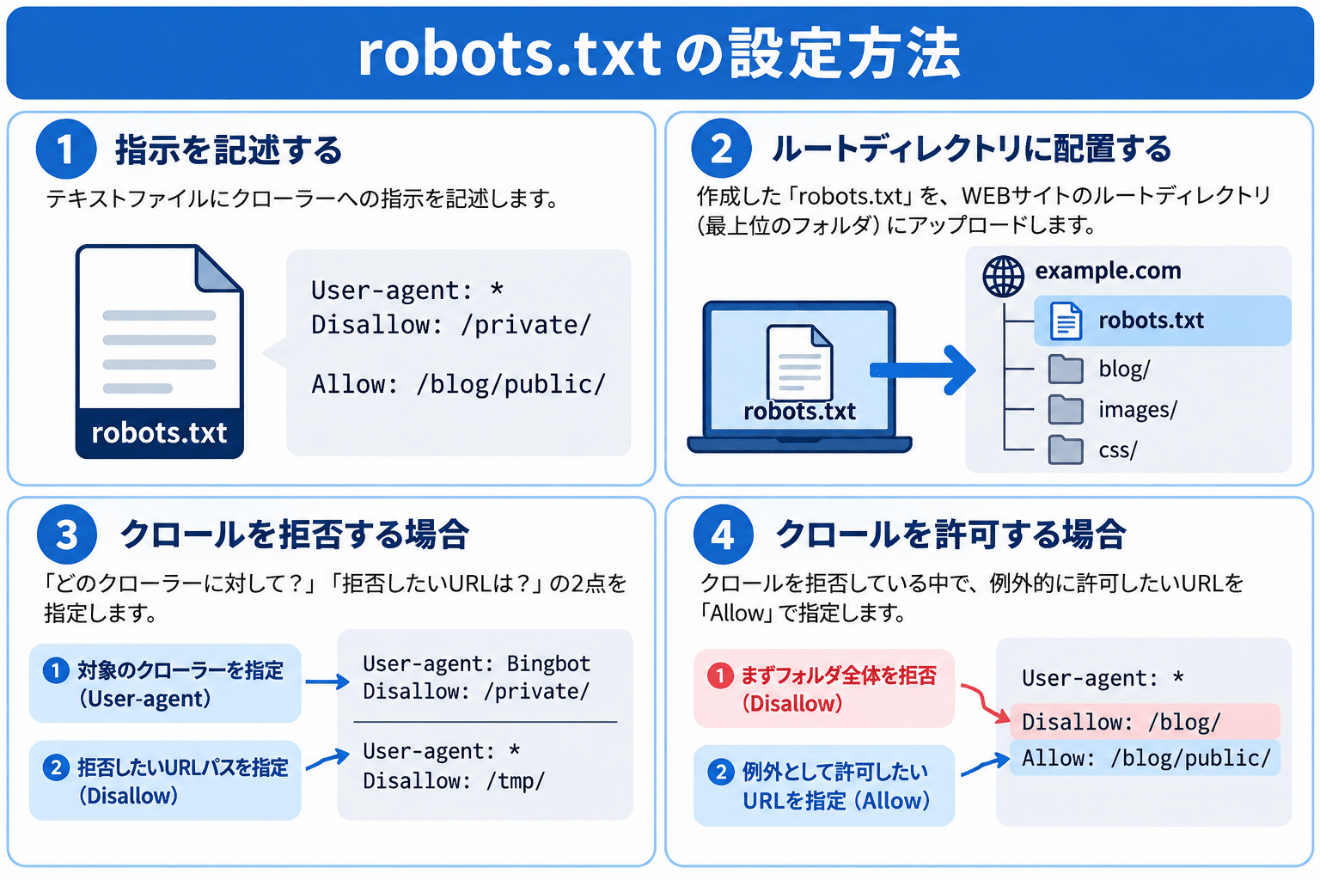
WEBサイトのファイルを公開するスペースにおいて、最上位のフォルダのことをルートディレクトリといいます。そして、GoogleSearchCentralによると、robots.txtはそのルートディレクトリに配置されるテキストファイルで、検索エンジンのクローラー(WEBサイトを巡回する自動プログラム)に対して、どのページへのアクセスを許可・拒否するかを指示する役割があります。
通常は、不要なページのインデックス防止や、サーバーへの負荷を抑えて巡回効率(クロールバジェット)を最適化するために利用されます。
robots.txtのSEO効果
robots.txtを設定することでえられる主なSEO効果は、検索エンジンのクローラーに対して巡回の優先順位を伝え、サイト内の重要なページへリソース(クロールバジェット)を集中させられる点です。不要なページや重複コンテンツへの巡回を抑制することで、クロールの無駄を防ぎ、価値あるコンテンツや新規ページを効率よく検索結果にインデックス登録させることができます。
さらに、ファイル内にXMLサイトマップのURLを記載して重要ページへの案内をスムーズにできるほか、サーバーへの不必要なアクセス負荷を軽減してWEBサイトの表示速度向上にも役立ちます。
robots.txtの設定方法
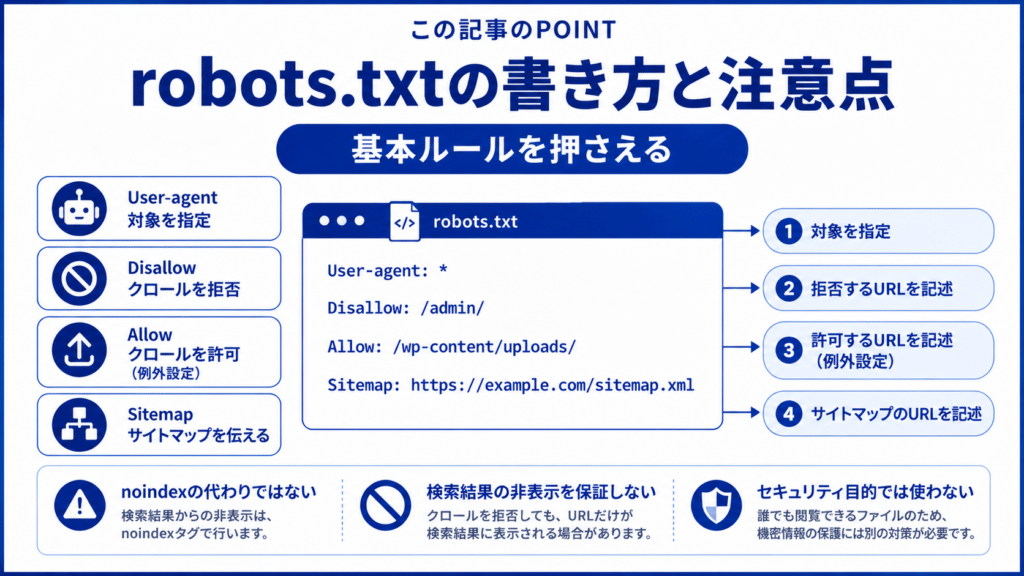
robots.txtは、テキストファイルにクローラーへの指示を記述し、上述したWEBサイトのルートディレクトリに設定します。「User-agent」で対象となるクローラーを指定し、「Disallow」や「Allow」を使ってクロールの拒否・許可を指示します。
設定方法はそれほど難しくありませんが、記述を誤ると重要なページへのクロールを妨げる可能性があるため、正しいルールを理解しておいてください。ここでは、クロールを拒否する場合と許可する場合に分けて、具体的な設定方法を解説します。
拒否する場合
robots.txtでクロールを拒否するには、テキストファイル内で「どのクローラーに対して?」と「拒否したいURLは?」の2点を指定します。まず、最初に対象とするクローラーをUser-agentで記述します。例えば、Bingを対象とするなら「User-agent: Bingbot」と記述します。また、すべての検索エンジンが対象なら「User-agent: 」のように(アスタリスク)を使用します。アスタリスクはWindowsの場合、「Shift」キーを押しながら「け」のキーを押すと入力できます。
対象とするクローラーを選択したら、次は「拒否したいURLパス」を指定します。例えば、特定フォルダを拒否する場合はDisallow: /private/のように記述します。以上の要領で作成したファイルは「robots.txt」という名前でWEBサイトのルートディレクトリに配置し完了です。
許可する場合
次は、許可する場合をお伝えします。しかし、そもそもrobots.txtは、クロールを拒否するためのものなのに、なぜわざわざ許可するための指示を出さないといけないのかと疑問に思うかも知れません。たしかに、何も制限していなければ、原則としてクローラーはサイトを巡回できます。
ただ、クロールを拒否している中で、例外的に許可したいというケースがあります。例えば、「Disallow: /blog/ Allow: /blog/public/」のように設定すれば、/blog/以下のクロールを禁止しながら、/blog/public/以下だけは許可しています。このように、クロール制限に例外を設けるために使用すると理解してください。
以上のような方法で拒否・許可をおこないますが、Crawling infrastructureの「Google による robots.txt の指定の解釈」もあわせてご確認ください。
robots.txtの確認方法
WEBサイトの robots.txt ファイルを確認する簡単な方法としては、ブラウザのアドレスバーに確認したいサイトのトップページURLの末尾に「/robots.txt」(例:https://123abcdef.net/robots.txt) を付け加えて直接アクセスする方法があります。ファイルが存在していれば、クローラーへの指示内容がプレーンテキストでそのまま画面に表示されます。
robots.txtでクロールを拒否しない方が良いページ
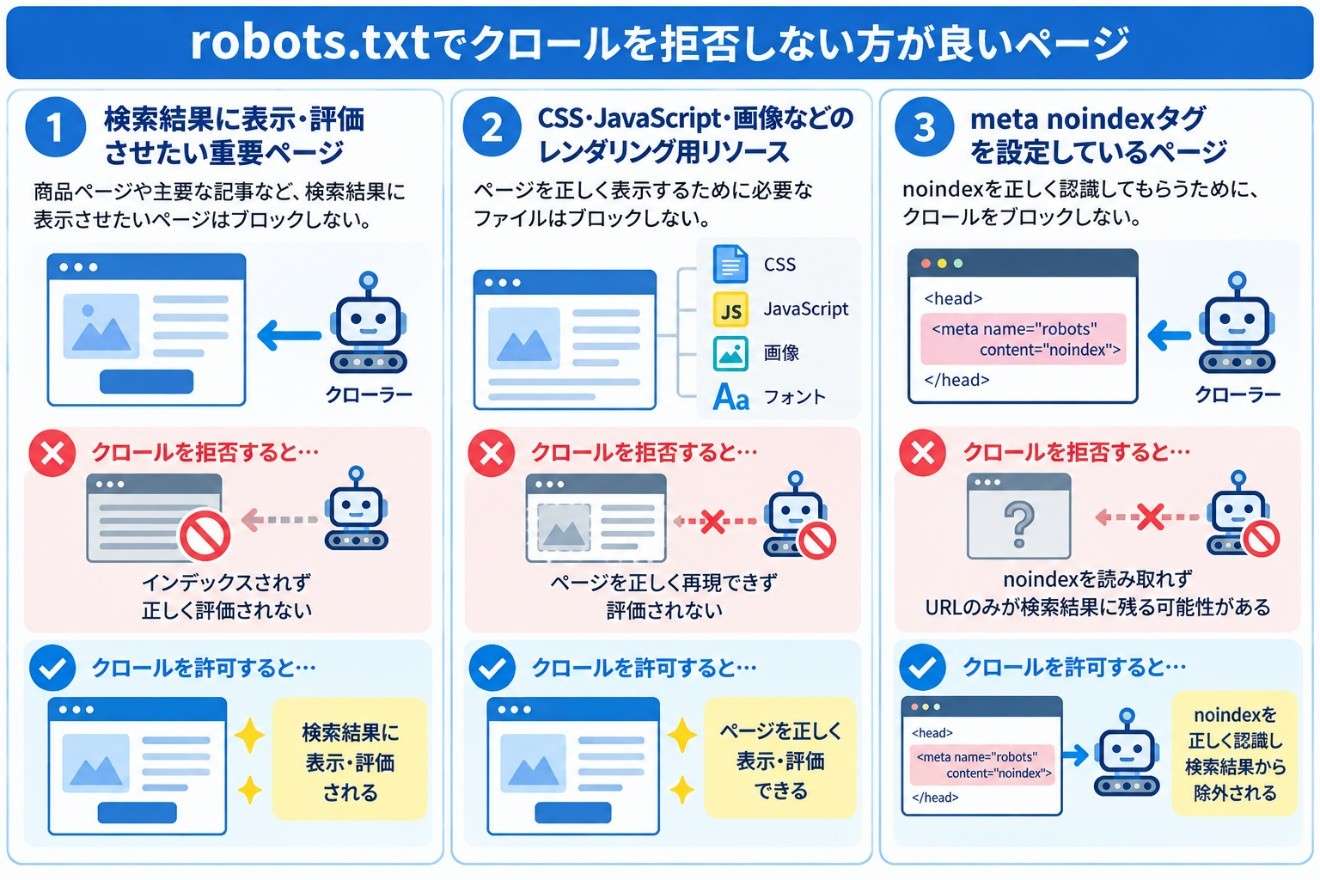
robots.txtは、検索エンジンのクローラーによる巡回を制御できる便利な仕組みですが、すべてのページでクロールを拒否して良いわけではありません。重要なページや特定のファイルへのクロールを誤って拒否すると、検索エンジンがコンテンツを正しく認識できず、SEOに悪影響を及ぼす可能性があります。
そのため、robots.txtを設定する際は、クロールを拒否すべきページだけでなく、拒否しない方が良いページについても理解しておくことが大切です。ここでは、特に注意したい3つのケースを紹介します。
検索結果に表示・評価させたい重要ページ
検索結果に表示・評価させたい重要ページ(商品ページや主要な記事など)を robots.txt で誤ってクロール拒否してしまうと、検索エンジンのクローラーがページ内に巡回できず、コンテンツやテキストを正しく読み込んで評価することができなくなります。
クローラーが評価できないと、検索エンジンに適切にインデックス登録されなかったり、説明文(スニペット)が表示されないURLのみの状態で検索結果に掲載されるなどして、検索順位に悪影響を及ぼします。そのため、ユーザーに見てもらいたい重要ページは遮断せず、クローラーが制限なくアクセスできる状態にしておくことがSEOでは重要です。
CSS・JavaScript・画像などのレンダリング用リソース
レンダリング用リソースとは、WEBページをブラウザで正しく表示するために必要なデータのことです。例えば、CSSやJavaScript、画像、フォントなどが該当します。ページを表示するときには、これらのレンダリング用リソースから必要なデータを取得し、画面上に正しく表示します。
そのため、レンダリング用のファイルを robots.txt で拒否してしまうと、クローラーがページを正しく再現できず、コンテンツが正しく評価されなくなります。レンダリングに必要なこれらのファイルへのアクセスは遮断せず、常にクロール可能な状態にしておくことが大切です。
meta noindex タグを設定しているページ
meta noindex タグを設定したページをrobots.txt でクロール拒否することは不適切です。検索エンジンのクローラーがページへアクセスできなくなると、HTML内に書かれた noindex 指示自体を読み取れなくなってしまうからです。検索エンジンがページを検索結果(インデックス)から削除するには、実際にページを巡回して noindex タグを確認する必要があります。もし robots.txt でクロールを遮断してしまうと非表示の指示がクローラーに伝わらず、他サイトからのリンクなどを通じてURL単体で検索結果に残るリスクが生じます。
したがって、特定のページを検索結果から除外したい場合は、robots.txt でブロックせずにクローラーが正常に巡回して noindex を読み込める状態にしてください。また、noindex の具体的な設定方法については「noindexとnofollowの書き方は?meta robotsとrel属性の記述方法を解説」を参照してください。
robots.txtの注意点
robots.txtは、検索エンジンのクローラーによる巡回を制御するために役立ちますが、設定する際にはいくつかの注意点があります。ここでは、robots.txtを設定する際に知っておきたい3つの注意点について解説します。
セキュリティ目的では使わない
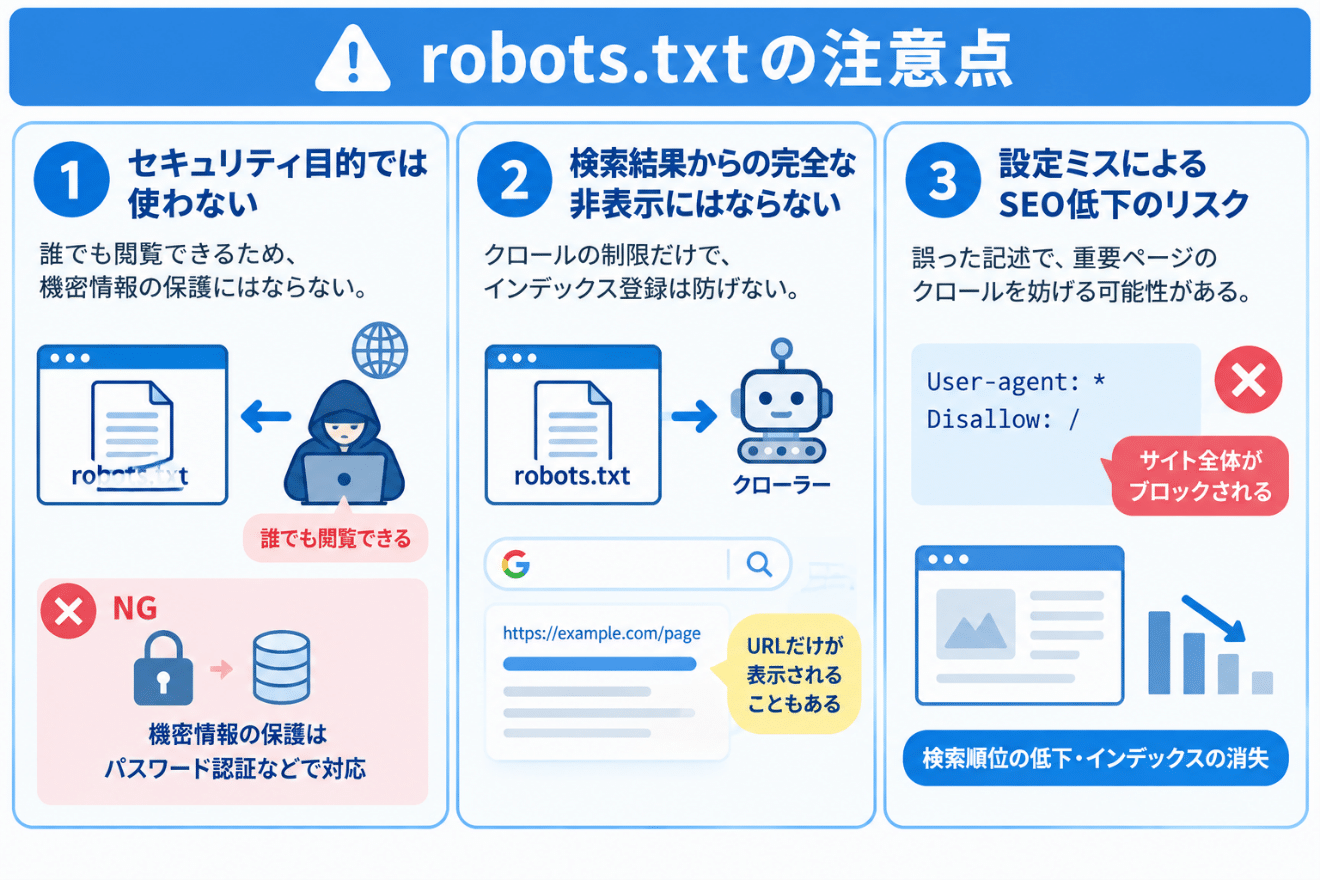
robots.txtをセキュリティ目的で使用してはいけません。robots.txtを使用しても、ファイルは誰でもWEB上で閲覧できる公開になっているためです。そのため、個人情報や社内データなどの機密情報を安全に保護するには、パスワード認証などより確実なセキュリティ対策を導入する必要があります。
検索結果からの完全な非表示にはならない
Robots.txtで拒否しても、検索結果から非表示にできるとは限りません。クローラーがページに訪問するのを制限する指示に過ぎず、検索結果へのインデックス登録を直接防ぐものではないです。
例えば、外部サイトやWEBサイト内の別ページから該当URLへリンクが張られていれば、検索エンジンはページ本文を巡回しないままURL情報だけを認識し、説明文(スニペット)を表示しない状態で検索結果に掲載してしまうことがあります。
設定ミスによるSEO低下のリスク
記述ミスしていると、検索エンジンがWEBサイト内のコンテンツを正しく巡回できなくなるため、検索順位の下降やインデックスの消失といった結果になる可能性があります。例えば、構文を誤ってDisallow: /と記述してしまうとWEBサイト全体の巡回が遮断され、重要ページが検索結果に表示されなくなります。
また、ページの表示に必要なCSSやJavaScriptファイルを誤ってブロックすると、検索エンジンが人間と同じようにページをレンダリングできず正しい評価をしてもらえません。そのため、ファイルを本番環境へアップロード・変更する際は、Google Search Consoleの検証ツールなどを利用して正しく設定されているかテストしてください。
robots.txtのよくある質問
ここでは、robots.txtについてよくある質問を取り上げ解説します。実際に設定する前にお読みください。
Q.robots.txtでクロールを禁止しても検索結果に表示されることはありますか?
Answer)はい、あります。例えば、外部サイトからリンクを張られている場合、Googleがページの存在を認識し、検索結果に表示することがあります。検索結果に表示させたくない場合は、原則としてnoindexを使用してください。
Q.設定を変更すると、Googleにはすぐに反映されますか?
Answer)通常は、反映まで一定期間がかかります。変更後はGoogle Search Consoleのrobots.txtレポートなどで、Googleが最新の情報を読み取っているか確認してください。
Q.robots.txtを設定していないサイトは、SEOで不利になりますか?
Answer)設置していないこと自体がSEOで不利になることはありません。単純に「クロールの制限がない」と扱いになります。
Q.記述したルールは、すべての検索エンジンに適用されますか?
Answer)いいえ、すべてのクローラーがルールにしたがう訳ではありません。GooglebotやBingなどの主要な検索エンジンは、基本的にrobots.txtのルールを尊重しますが、一部の悪質なクローラーや自動収集プログラムは、ルールを無視してアクセスする可能性があります。
まとめ
robots.txtは、検索エンジンのクローラーによる巡回を制御し、WEBサイトのクロール効率を改善するのに役立ちます。早速自社でも、巡回の必要がないページをリストアップし、今回お伝えした方法で対応を進めてください。ただし、robots.txt自体が検索順位を直接高めるわけではなく、すべてのWEBサイトで細かな設定が必要になるわけでもありません。そのため、サイト規模や目的を踏まえて、慎重に設定してください。
この記事の監修者
日本大学法学部卒業、広告代理店で12年間働いている間、SEOと出会い、SEO草創期からSEO研究を始める。SEOを独学で研究し100以上のサイトで実験と検証を繰り返しました。そのノウハウを元に起業し現在、11期目。営業、SEOコンサル、WEB解析(Googleアナリティクス個人認定資格GAIQ保持)コーディング、サイト制作となんでもこなす。会社としては今まで2000以上のサイトのSEO対策を手掛けてきました。